本文转载自力扣讨论区,作者:灵茶山艾府(endlesscheng)。 原文链接:https://leetcode.cn/circle/discuss/SJFwQI/
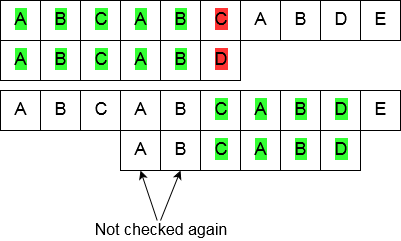
一、KMP(前缀的后缀)
定义
定义
对于模式串
利用
注:
数组的定义来自《算法导论》。国内数据结构教材通常定义为 数组,有的教材下标是从 开始的,也有从 开始的(但在数组最前面插入了一个 ),请读者注意甄别。总的来说,思路是共通的,只是实现上略有区别。
模板:
# 在文本串 text 中查找模式串 pattern,返回所有成功匹配的位置(pattern[0] 在 text 中的下标)
def kmp_search(text: str, pattern: str) -> List[int]:
    m = len(pattern)
    pi = [0] * m
    cnt = 0
    for i in range(1, m):
        b = pattern[i]
        while cnt and pattern[cnt] != b:
            cnt = pi[cnt - 1]
        if pattern[cnt] == b:
            cnt += 1
        pi[i] = cnt

    pos = []
    cnt = 0
    for i, b in enumerate(text):
        while cnt and pattern[cnt] != b:
            cnt = pi[cnt - 1]
        if pattern[cnt] == b:
            cnt += 1
        if cnt == len(pattern):
            pos.append(i - m + 1)
            cnt = pi[cnt - 1]
return posclass Solution {
// 在文本串 text 中查找模式串 pattern,返回所有成功匹配的位置(pattern[0] 在 text 中的下标)
private List<Integer> kmpSearch(char[] text, char[] pattern) {
int m = pattern.length;
int[] pi = new int[m];
int cnt = 0;
for (int i = 1; i < m; i++) {
char b = pattern[i];
while (cnt > 0 && pattern[cnt] != b) {
cnt = pi[cnt - 1];
}
if (pattern[cnt] == b) {
cnt++;
}
pi[i] = cnt;
}
List<Integer> pos = new ArrayList<>();
cnt = 0;
for (int i = 0; i < text.length; i++) {
char b = text[i];
while (cnt > 0 && pattern[cnt] != b) {
cnt = pi[cnt - 1];
}
if (pattern[cnt] == b) {
cnt++;
}
if (cnt == m) {
pos.add(i - m + 1);
cnt = pi[cnt - 1];
}
}
return pos;
}
}// 在文本串 text 中查找模式串 pattern,返回所有成功匹配的位置(pattern[0] 在 text 中的下标)
vector<int> kmp_search(const string& text, const string& pattern) {
int m = pattern.size();
vector<int> pi(m);
int cnt = 0;
for (int i = 1; i < m; i++) {
char b = pattern[i];
while (cnt && pattern[cnt] != b) {
cnt = pi[cnt - 1];
}
if (pattern[cnt] == b) {
cnt++;
}
pi[i] = cnt;
}
vector<int> pos;
cnt = 0;
for (int i = 0; i < text.size(); i++) {
char b = text[i];
while (cnt && pattern[cnt] != b) {
cnt = pi[cnt - 1];
}
if (pattern[cnt] == b) {
cnt++;
}
if (cnt == m) {
pos.push_back(i - m + 1);
cnt = pi[cnt - 1];
}
}
return pos;
}// 在文本串 text 中查找模式串 pattern,返回所有成功匹配的位置(pattern[0] 在 text 中的下标)
func kmpSearch(text, pattern string) (pos []int) {
m := len(pattern)
pi := make([]int, m)
cnt := 0
for i := 1; i < m; i++ {
b := pattern[i]
for cnt > 0 && pattern[cnt] != b {
cnt = pi[cnt-1]
}
if pattern[cnt] == b {
cnt++
}
pi[i] = cnt
}
cnt = 0
for i, b := range text {
for cnt > 0 && pattern[cnt] != byte(b) {
cnt = pi[cnt-1]
}
if pattern[cnt] == byte(b) {
cnt++
}
if cnt == m {
pos = append(pos, i-m+1)
cnt = pi[cnt-1]
}
}
return
}- 28. 找出字符串中第一个匹配项的下标 模板题
- 796. 旋转字符串 做到线性时间复杂度
- 1392. 最长快乐前缀 1876
- 3036. 匹配模式数组的子数组数目 II 1895
- 1764. 通过连接另一个数组的子数组得到一个数组 做到线性时间复杂度
- 1668. 最大重复子字符串 做到线性时间复杂度
- 459. 重复的子字符串 做到线性时间复杂度
- 2800. 包含三个字符串的最短字符串 做到线性时间复杂度
- 3008. 找出数组中的美丽下标 II 2016
- 214. 最短回文串 也可以用 Manacher 算法
- 3529. 统计水平子串和垂直子串重叠格子的数目 2105
- 686. 重复叠加字符串匹配 约 2200
- 3455. 最短匹配子字符串 2303
- 1397. 找到所有好字符串 2667
- 3037. 在无限流中寻找模式 II(会员题)同 28 题
- 3571. 最短超级串 II(会员题)联系 2800 题
二、Z 函数(后缀的前缀)
注:在国内算法竞赛圈,这个算法也叫扩展 KMP。
对于字符串
常用技巧是构造字符串
所以上面的一些 KMP 题目(子串匹配相关的),也可以用 Z 函数解决。读者可以尝试用 Z 函数解决 28. 找出字符串中第一个匹配项的下标。
模板:
# 计算并返回 z 数组,其中 z[i] = |LCP(s[i:], s)|
def calc_z(s: str) -> List[int]:
    n = len(s)
    z = [0] * n
    box_l = box_r = 0
    for i in range(1, n):
        if i <= box_r:
            z[i] = min(z[i - box_l], box_r - i + 1)
        while i + z[i] < n and s[z[i]] == s[i + z[i]]:
            box_l, box_r = i, i + z[i]
            z[i] += 1
    z[0] = n
return zclass Solution {
// 计算并返回 z 数组,其中 z[i] = |LCP(s[i:], s)|
private int[] calcZ(char[] s) {
int n = s.length;
int[] z = new int[n];
int boxL = 0;
int boxR = 0;
for (int i = 1; i < n; i++) {
if (i <= boxR) {
z[i] = Math.min(z[i - boxL], boxR - i + 1);
}
while (i + z[i] < n && s[z[i]] == s[i + z[i]]) {
boxL = i;
boxR = i + z[i];
z[i]++;
}
}
z[0] = n;
return z;
}
}// 计算并返回 z 数组,其中 z[i] = |LCP(s[i:], s)|
vector<int> calc_z(const string& s) {
int n = s.size();
vector<int> z(n);
int box_l = 0, box_r = 0;
for (int i = 1; i < n; i++) {
if (i <= box_r) {
z[i] = min(z[i - box_l], box_r - i + 1);
}
while (i + z[i] < n && s[z[i]] == s[i + z[i]]) {
box_l = i;
box_r = i + z[i];
z[i]++;
}
}
z[0] = n;
return z;
}// 计算并返回 z 数组,其中 z[i] = |LCP(s[i:], s)|
func calcZ(s string) []int {
n := len(s)
z := make([]int, n)
boxL, boxR := 0, 0
for i := 1; i < n; i++ {
if i <= boxR {
z[i] = min(z[i-boxL], boxR-i+1)
}
for i+z[i] < n && s[z[i]] == s[i+z[i]] {
boxL, boxR = i, i+z[i]
z[i]++
}
}
z[0] = n
return z
}- 2223. 构造字符串的总得分和 2220 模板题
- 3031. 将单词恢复初始状态所需的最短时间 II 2278
- 3045. 统计前后缀下标对 II 2328
- 3303. 第一个几乎相等子字符串的下标 2509
- 3292. 形成目标字符串需要的最少字符串数 II 2662
- 3474. 字典序最小的生成字符串 做到
LCP 数组
- 2430. 对字母串可执行的最大删除数 2102
- 3388. 统计数组中的美丽分割 2365
- 2573. 找出对应 LCP 矩阵的字符串 2682
- 1977. 划分数字的方案数 2817
三、Manacher 算法(回文串)
Manacher 算法可以计算以
此外,还可以:
- 判断任意子串是否为回文串。
- 计算从
开始的最长回文子串的长度。 - 计算以
结尾的最长回文子串的长度。
Z 函数和 Manacher 算法都会用到类似 Z-box 的概念,在学习时,可以对比体会。
- 5. 最长回文子串 模板题
- 647. 回文子串 计算回文子串个数
- 214. 最短回文串
- 3985. 回文子数组求和 2202
- 3327. 判断 DFS 字符串是否是回文串 2454
- 1745. 分割回文串 IV 做到
- 1960. 两个回文子字符串长度的最大乘积 2691
- 3844. 最长的准回文子字符串 做到
- 3504. 子字符串连接后的最长回文串 II 做到
用到中心扩展法(及其思想)的算法题:
- 5. 最长回文子串 模板题
- 3844. 最长的准回文子字符串 1990
- 2472. 不重叠回文子字符串的最大数目 2013
- 3504. 子字符串连接后的最长回文串 II 2398
- 3615. 图中的最长回文路径 2463
- 3579. 字符串转换需要的最小操作数 做到
四、字符串哈希
本题单的大多数题目都可以用字符串哈希解决。
推荐先把 2156. 查找给定哈希值的子串 和 3756. 连接非零数字并乘以其数字和 II 做了,对理解多项式哈希的计算方法有帮助。
模板代码见 我的题解,包含单模哈希和双模哈希。
小技巧:我们可以用字符串哈希比较两个子串的字典序大小。做法是二分长度,计算最长公共前缀(LCP),然后比较 LCP 的下一个字母(一定不同,或者不存在),即可判断两个子串谁大谁小。时间复杂度:
- 28. 找出字符串中第一个匹配项的下标
- 187. 重复的 DNA 序列
- 1316. 不同的循环子字符串 1837
- 1297. 子串的最大出现次数 做到
- 2261. 含最多 K 个可整除元素的子数组 做到
- 3722. 反转后字典序最小的字符串 做到
- 3934. 最短唯一子数组 2163
- 3213. 最小代价构造字符串 2171
- 1367. 二叉树中的链表 做到线性
- 1044. 最长重复子串 2429
- 718. 最长重复子数组
- 1923. 最长公共子路径 2661
- 3292. 形成目标字符串需要的最少字符串数 II 2662
- 3844. 最长的准回文子字符串 做到
或 - 2168. 每个数字的频率都相同的不同子字符串的数量(会员题)同 2261 题
- 1554. 只有一个不同字符的字符串(会员题)
- 1062. 最长重复子串(会员题)同 1044 题
五、最小表示法
定义循环左移操作:把字符串
问题:你可以执行任意次循环左移操作,计算你能得到的字典序最小的字符串。
注:任意次循环左移操作后,得到的字符串叫做
# 返回 s 的字典序最小的循环同构串
# 时间复杂度 O(|s|),证明见代码末尾的注释
def smallestRepresentation(s: str) -> str:
    n = len(s)
    s += s
    i = 0  # 始终指向当前最小子串的首字母下标
    j = 1  # 指向需要和 i 比较的子串的首字母下标
    while j < n:
        # 暴力比较:是 i 开头的字典序小,还是 j 开头的字典序小?
        k = 0
        while k < n and s[i + k] == s[j + k]:
            k += 1
        if k >= n:
            # s 是个周期字符串,周期为 j-i
            # j+d 开头的子串等于 i+d 开头的子串,而这些子串我们之前已经排除了,继续遍历不会找到更小的
            break

        if s[i + k] < s[j + k]:  # 注:如果求字典序最大,改成 >
            # 比如从 i 开始是 "aaab",从 j 开始是 "aaac"
            # 从 i 开始比从 j 开始更小(排除 j)
            # 此外:
            # 从 i+1 开始比从 j+1 开始更小,所以从 j+1 开始不可能是答案,排除
            # 从 i+2 开始比从 j+2 开始更小,所以从 j+2 开始不可能是答案,排除
            # ……
            # 从 i+k 开始比从 j+k 开始更小,所以从 j+k 开始不可能是答案,排除
            # 所以下一个「可能是答案」的开始位置是 j+k+1
            j += k + 1
        else:
            # 从 j 开始比从 i 开始更小,更新 i=j(也意味着我们排除了 i)
            # 此外:
            # 从 j+1 开始比从 i+1 开始更小,所以从 i+1 开始不可能是答案,排除
            # 从 j+2 开始比从 i+2 开始更小,所以从 i+2 开始不可能是答案,排除
            # ……
            # 从 j+k 开始比从 i+k 开始更小,所以从 i+k 开始不可能是答案,排除
            # 所以把 j 跳到 i+k+1,不过这可能比 j+1 小,所以与 j+1 取 max
            # 综上所述,下一个「可能是答案」的开始位置是 max(j+1, i+k+1)
            i, j = j, max(j, i + k) + 1

        # 每次要么排除 k+1 个与 i 相关的位置(这样的位置至多 n 个),要么排除 k+1 个与 j 相关的位置(这样的位置至多 n 个)
        # 所以上面关于 k 的循环,∑k <= 2n,所以二重循环的总循环次数是 O(n) 的

return s[i: i + n]class Solution {
// 返回 s 的字典序最小的循环同构串
// 时间复杂度 O(|s|),证明见代码末尾的注释
public String smallestRepresentation(String S) {
int n = S.length();
char[] s = (S + S).toCharArray();
int i = 0; // 始终指向当前最小子串的首字母下标
int j = 1; // 指向需要和 i 比较的子串的首字母下标
while (j < n) {
// 暴力比较:是 i 开头的字典序小,还是 j 开头的字典序小?
int k = 0;
while (k < n && s[i + k] == s[j + k]) {
k++;
}
if (k >= n) {
// s 是个周期字符串,周期为 j-i
// j+d 开头的子串等于 i+d 开头的子串,而这些子串我们之前已经排除了,继续遍历不会找到更小的
break;
}
if (s[i + k] < s[j + k]) { // 注:如果求字典序最大,改成 >
// 比如从 i 开始是 "aaab",从 j 开始是 "aaac"
// 从 i 开始比从 j 开始更小(排除 j)
// 此外:
// 从 i+1 开始比从 j+1 开始更小,所以从 j+1 开始不可能是答案,排除
// 从 i+2 开始比从 j+2 开始更小,所以从 j+2 开始不可能是答案,排除
// ……
// 从 i+k 开始比从 j+k 开始更小,所以从 j+k 开始不可能是答案,排除
// 所以下一个「可能是答案」的开始位置是 j+k+1
j += k + 1;
} else {
// 从 j 开始比从 i 开始更小,更新 i=j(也意味着我们排除了 i)
// 此外:
// 从 j+1 开始比从 i+1 开始更小,所以从 i+1 开始不可能是答案,排除
// 从 j+2 开始比从 i+2 开始更小,所以从 i+2 开始不可能是答案,排除
// ……
// 从 j+k 开始比从 i+k 开始更小,所以从 i+k 开始不可能是答案,排除
// 所以把 j 跳到 i+k+1,不过这可能比 j+1 小,所以与 j+1 取 max
// 综上所述,下一个「可能是答案」的开始位置是 max(j+1, i+k+1)
int tmp = j;
j = Math.max(j, i + k) + 1;
i = tmp;
}
// 每次要么排除 k+1 个与 i 相关的位置(这样的位置至多 n 个),要么排除 k+1 个与 j 相关的位置(这样的位置至多 n 个)
// 所以上面关于 k 的循环,∑k <= 2n,所以二重循环的总循环次数是 O(n) 的
}
return new String(s, i, n);
}
}// 返回 s 的字典序最小的循环同构串
// 时间复杂度 O(|s|),证明见代码末尾的注释
string smallestRepresentation(string s) {
int n = s.size();
s += s;
int i = 0; // 始终指向当前最小子串的首字母下标
int j = 1; // 指向需要和 i 比较的子串的首字母下标
while (j < n) {
// 暴力比较:是 i 开头的字典序小,还是 j 开头的字典序小?
int k = 0;
while (k < n && s[i + k] == s[j + k]) {
k++;
}
if (k >= n) {
// s 是个周期字符串,周期为 j-i
// j+d 开头的子串等于 i+d 开头的子串,而这些子串我们之前已经排除了,继续遍历不会找到更小的
break;
}
if (s[i + k] < s[j + k]) { // 注:如果求字典序最大,改成 >
// 比如从 i 开始是 "aaab",从 j 开始是 "aaac"
// 从 i 开始比从 j 开始更小(排除 j)
// 此外:
// 从 i+1 开始比从 j+1 开始更小,所以从 j+1 开始不可能是答案,排除
// 从 i+2 开始比从 j+2 开始更小,所以从 j+2 开始不可能是答案,排除
// ……
// 从 i+k 开始比从 j+k 开始更小,所以从 j+k 开始不可能是答案,排除
// 所以下一个「可能是答案」的开始位置是 j+k+1
j += k + 1;
} else {
// 从 j 开始比从 i 开始更小,更新 i=j(也意味着我们排除了 i)
// 此外:
// 从 j+1 开始比从 i+1 开始更小,所以从 i+1 开始不可能是答案,排除
// 从 j+2 开始比从 i+2 开始更小,所以从 i+2 开始不可能是答案,排除
// ……
// 从 j+k 开始比从 i+k 开始更小,所以从 i+k 开始不可能是答案,排除
// 所以把 j 跳到 i+k+1,不过这可能比 j+1 小,所以与 j+1 取 max
// 综上所述,下一个「可能是答案」的开始位置是 max(j+1, i+k+1)
int tmp = j;
j = max(j, i + k) + 1;
i = tmp;
}
// 每次要么排除 k+1 个与 i 相关的位置(这样的位置至多 n 个),要么排除 k+1 个与 j 相关的位置(这样的位置至多 n 个)
// 所以上面关于 k 的循环,∑k <= 2n,所以二重循环的总循环次数是 O(n) 的
}
return s.substr(i, n);
}// 返回 s 的字典序最小的循环同构串
// 时间复杂度 O(|s|),证明见代码末尾的注释
func smallestRepresentation(s string) string {
n := len(s)
s += s
i := 0 // 始终指向当前最小子串的首字母下标
j := 1 // 指向需要和 i 比较的子串的首字母下标
for j < n {
// 暴力比较:是 i 开头的字典序小,还是 j 开头的字典序小?
k := 0
for k < n && s[i+k] == s[j+k] {
k++
}
if k >= n {
// s 是个周期字符串,周期为 j-i
// j+d 开头的子串等于 i+d 开头的子串,而这些子串我们之前已经排除了,继续遍历不会找到更小的
break
}
if s[i+k] < s[j+k] { // 注:如果求字典序最大,改成 >
// 比如从 i 开始是 "aaab",从 j 开始是 "aaac"
// 从 i 开始比从 j 开始更小(排除 j)
// 此外:
// 从 i+1 开始比从 j+1 开始更小,所以从 j+1 开始不可能是答案,排除
// 从 i+2 开始比从 j+2 开始更小,所以从 j+2 开始不可能是答案,排除
// ……
// 从 i+k 开始比从 j+k 开始更小,所以从 j+k 开始不可能是答案,排除
// 所以下一个「可能是答案」的开始位置是 j+k+1
j += k + 1
} else {
// 从 j 开始比从 i 开始更小,更新 i=j(也意味着我们排除了 i)
// 此外:
// 从 j+1 开始比从 i+1 开始更小,所以从 i+1 开始不可能是答案,排除
// 从 j+2 开始比从 i+2 开始更小,所以从 i+2 开始不可能是答案,排除
// ……
// 从 j+k 开始比从 i+k 开始更小,所以从 i+k 开始不可能是答案,排除
// 所以把 j 跳到 i+k+1,不过这可能比 j+1 小,所以与 j+1 取 max
// 综上所述,下一个「可能是答案」的开始位置是 max(j+1, i+k+1)
i, j = j, max(j, i+k)+1
}
// 每次要么排除 k+1 个与 i 相关的位置(这样的位置至多 n 个),要么排除 k+1 个与 j 相关的位置(这样的位置至多 n 个)
// 所以上面关于 k 的循环,∑k <= 2n,所以二重循环的总循环次数是 O(n) 的
}
return s[i : i+n]
}推荐先完成 1163. 按字典序排在最后的子串,最小表示法是这题的环形版本。
- 899. 有序队列
的情况即为最小表示法,可以 解决 - 3403. 从盒子中找出字典序最大的字符串 I
- 1625. 执行操作后字典序最小的字符串
- 3406. 从盒子中找出字典序最大的字符串 II(会员题)
- 1708. 长度为 K 的最大子数组(会员题)见进阶问题
六、字典树
- 见 数据结构题单 第六章。
七、AC 自动机
AC 自动机 = 字典树 + KMP。
由于这些题目也可以用其他算法(字符串哈希等)解决,难度分仅供参考。
- 1032. 字符流 1970 模板题
- 1967. 作为子字符串出现在单词中的字符串数目 模板题
- 面试题 17.17. 多次搜索 模板题
- 1408. 数组中的字符串匹配 做到线性时间复杂度
- 3213. 最小代价构造字符串 2171
- 2781. 最长合法子字符串的长度 2204
- 3292. 形成目标字符串需要的最少字符串数 II 2662
- 3758. 将数字词转换为数字(会员题)更通用的做法
八、后缀数组/后缀自动机
由于这些题目也可以用其他算法(字符串哈希等)解决,难度分仅供参考。
- 1163. 按字典序排在最后的子串 1864
- 1754. 构造字典序最大的合并字符串 做到
- 2904. 最短且字典序最小的美丽子字符串 做到
- 3722. 反转后字典序最小的字符串 做到
- 3934. 最短唯一子数组 2163
- 3213. 最小代价构造字符串 2171
- 1044. 最长重复子串 2429
- 718. 最长重复子数组
- 1923. 最长公共子路径 2661
- 1408. 数组中的字符串匹配
- 3729. 统计有序数组中可被 K 整除的子数组数量 不保证数组非递增的做法 本质不同子数组
- 3076. 数组中的最短非公共子字符串
- 3844. 最长的准回文子字符串 做到
- 3504. 子字符串连接后的最长回文串 II 做到
- 1316. 不同的循环子字符串
- 3388. 统计数组中的美丽分割 做到
或 - 2564. 子字符串异或查询 见我题解下的 评论
- 面试题 16.18. 模式匹配 后缀树
- 1698. 字符串的不同子字符串个数(会员题)
- 1062. 最长重复子串(会员题)同 1044 题
- 3135. 通过添加或删除结尾字符来同化字符串(会员题)
九、子序列自动机
上面都是和子串相关的算法,本节是和子序列相关的算法:子序列自动机。
虽然名字有些高大上,但实际上只是预处理
见 讲解 中的「进阶问题」。
- 792. 匹配子序列的单词数 1695
- 514. 自由之路 约 2400 做到
- 2014. 重复 K 次的最长子序列 2558
- 1055. 形成字符串的最短路径(会员题)
- 727. 最小窗口子序列(会员题)
十、其他
- 3485. 删除元素后 K 个字符串的最长公共前缀 2290 LCP 的性质
- 466. 统计重复个数 做到
- 3491. 电话号码前缀(会员题)非暴力做法
关联题单
- 数据结构题单 中的「六、字典树(trie)」。
- 滑动窗口与双指针题单 中的「§4.2 判断子序列」。
- 数学题单 中的「§7.5 多项式」。
- 贪心题单 中的「三、字符串贪心」。
算法题单
- 滑动窗口与双指针(定长/不定长/单序列/双序列/三指针/分组循环)
- 二分算法(二分答案/最小化最大值/最大化最小值/第K小)
- 单调栈(基础/矩形面积/贡献法/最小字典序)
- 网格图(DFS/BFS/综合应用)
- 位运算(基础/性质/拆位/试填/恒等式/思维)
- 图论算法(DFS/BFS/拓扑排序/基环树/最短路/最小生成树/网络流)
- 动态规划(入门/背包/划分/状态机/区间/状压/数位/数据结构优化/树形/博弈/概率期望)
- 常用数据结构(前缀和/差分/栈/队列/堆/字典树/并查集/树状数组/线段树)
- 数学算法(数论/组合/概率期望/博弈/计算几何/随机算法)
- 贪心与思维(基本贪心策略/反悔/区间/字典序/数学/思维/脑筋急转弯/构造)
- 链表、树与回溯(前后指针/快慢指针/DFS/BFS/直径/LCA)
- 字符串(KMP/Z函数/Manacher/字符串哈希/AC自动机/后缀数组/子序列自动机)
欢迎关注 B站@灵茶山艾府
如果你发现有题目可以补充进来,欢迎评论反馈。