XJTUSE-NLP-文本分类
- 文本分类的基本任务是什么?- 将文本划分到特定的主题下,例如政治、经济、体育等
分类步骤
Step 1:预处理
Step 2:文本表示
Step 3:分类模型
Step 4:评价
其它:特征选择
预处理
依据具体的文本形式及任务而定:
– 去除 HTML (or other)标签
– Stop-words(停用词):
• 高频词往往携带较少信息
• E.g., “a,an,the,this,for,at,on“ , ”的,得,地, 这,尽管,但是” etc。
– Word stemming(词干):
• 词的后缀及变形处理
• 将具有相同概念意义的词进行合并,例如 walk, walker, walked, and walking
文本表示
可以使用常见的 向量空间模型(VSM)来进行文本表示。- 将文本表示为由词条构成的向量- 理论上假设词条之间统计独立(不考虑词在文 本中的出现顺序),即文本是由词构成的词集 合(词袋, bag-of-words )
文档-词条矩阵 A=(aik)
– 每个文档表示为由词构成的列向量
– aik 表示词 k 在文档 i 中的权重
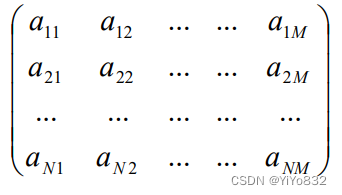 感觉说法有点问题,应该是每个文档表示为由词构成的行向量,PPT 可能有点问题?
现在说明几种 aik 的权重计算方式:
符号说明:
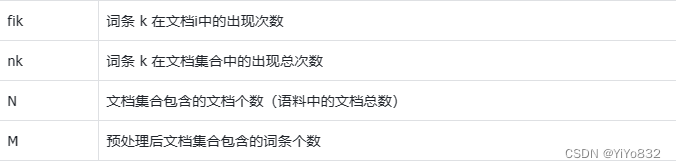
预处理后文档集合包含的词条个数
- 布尔权重:
如果词在文档中出现,则权重为1;否则为0- 词条频次权重(term frequency weighting, tf)
使用词条在文档中的出现次数作为词的权重- 逆文档频次(inverse document frequency, idf)
考虑包含某词条的文档个数
aik ∝ 1/nk- tf - idf 权重
同时考虑词条频次和逆文档频次
aik=fik∗log(Nnk)a_{ik} = f_{ik} * log(\frac{N}{n_k})aik=fik∗log(nkN)
分类模型
最近邻分类器
基于样例的方法,最近邻分类(有监督的学习)
定义两个样本点之间的距离函数
将新的样本划分到距离它最近的样本(最近邻)所属的类别 中
由于单纯的以最近的作为分类,很容易过拟合,因此可以考虑KNN
KNN
下面说明KNN算法步骤:- 选择参数K- 计算未知实例与所有已知实例的距离(可选择多种计算距离的方式,eg:欧氏距离,余弦距离)- 选择最近的K个已知实例- 根据少数服从多数多数的投票法则,让未知实例归类为K个最邻近样本中最多数的类别
朴素贝叶斯模型
给定类别C,假设变量X1,X2,X3…Xn之间相互独立
即:
P(X1X2...Xn∣C)=P(X1∣C)P(X2∣C)...P(Xn∣C)P(X_1X_2...X_n|C) = P(X_1|C)P(X_2|C)...P(X_n|C) P(X1X2...Xn∣C)=P(X1∣C)P(X2∣C)...P(Xn∣C)
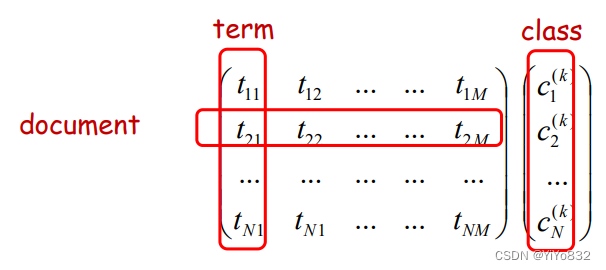
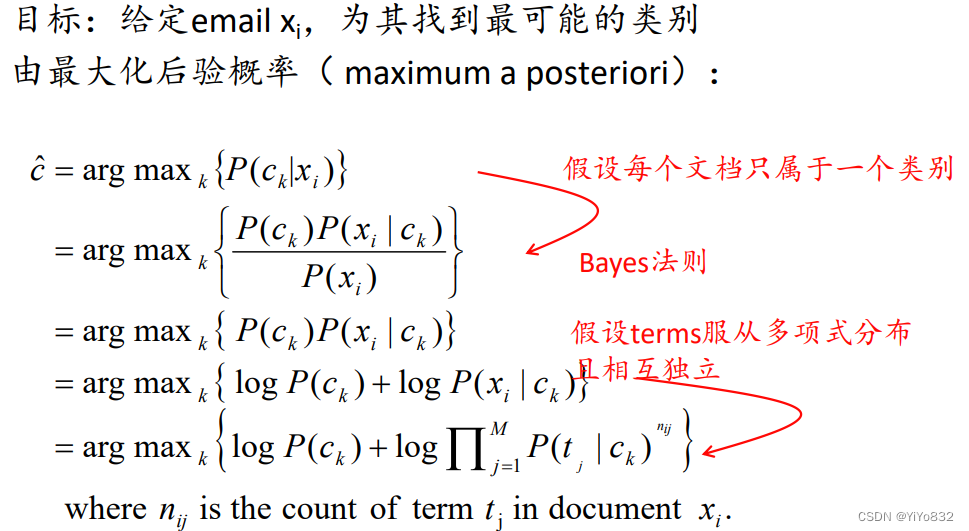 一定要结合矩阵进行理解!